Whisper APIで文字起こしを自動化するメリットとは?
📋 この記事でわかること
- ✅ 基本的な使い方と設定方法
- ✅ 実際の業務での活用例
- ✅ よくあるエラーと解決方法
- ✅ 効率的に使うためのコツ
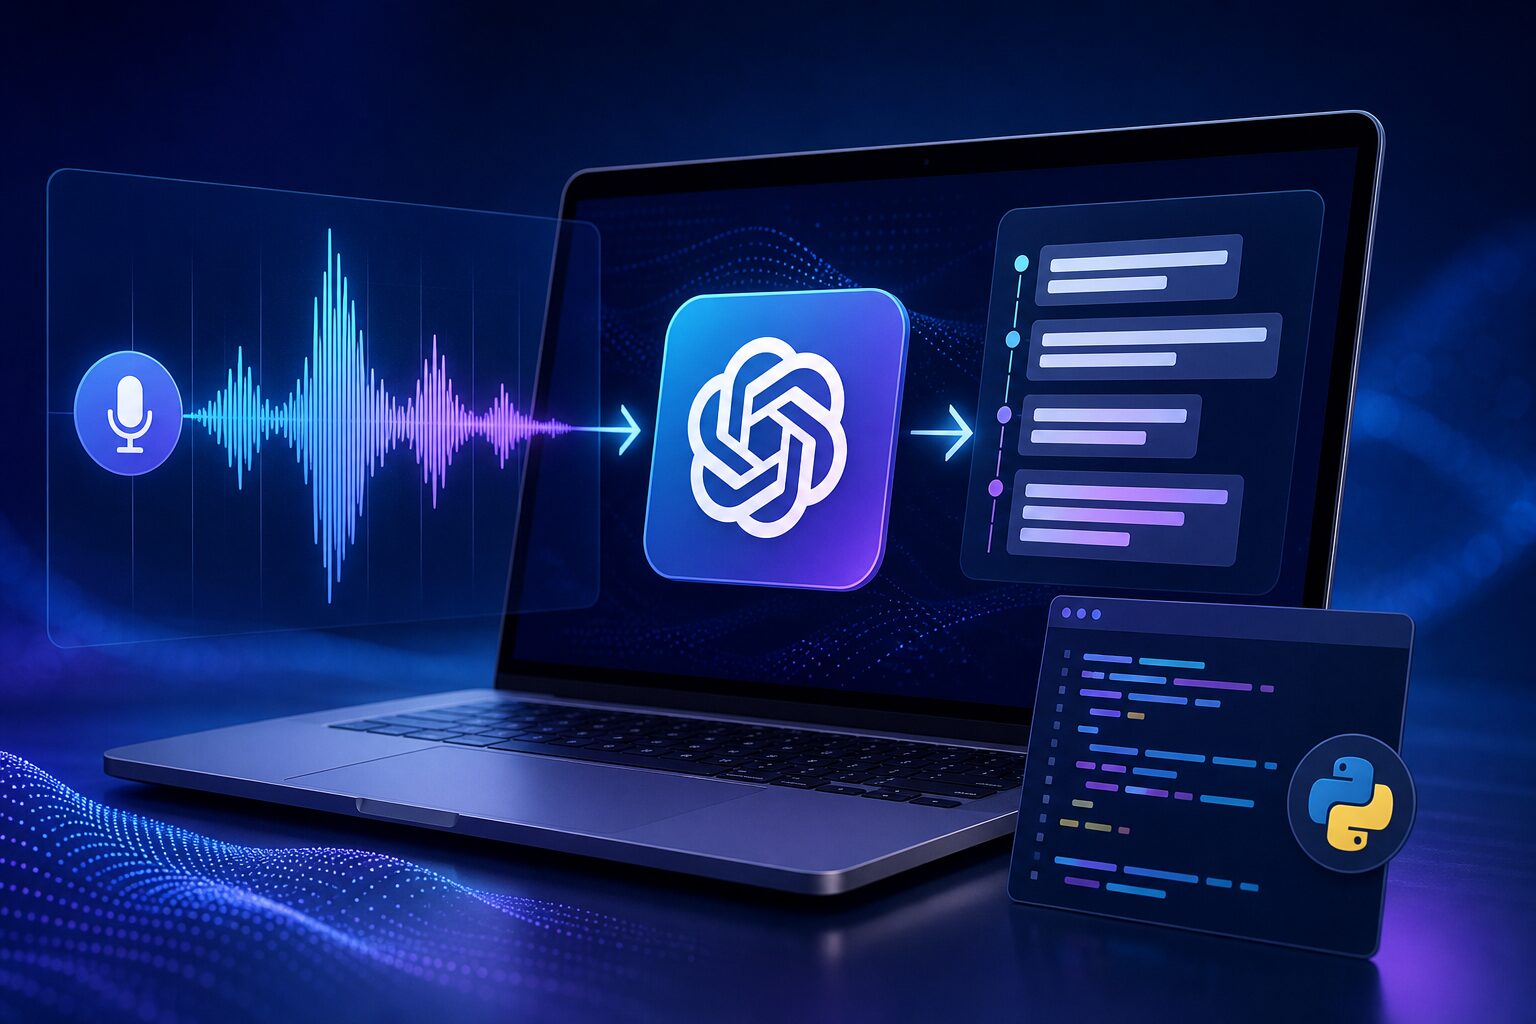
音声データの文字起こしに時間を取られていませんか?インタビューや会議、YouTube動画など、文字起こしが必要な場面は多いですよね。手作業だと1時間の音声に3〜4時間かかることもあります。そんな悩みを解決するのが、OpenAIが提供するWhisper APIです。Whisper APIを使えば、高精度な文字起こしをPythonで簡単に自動化できます。
Whisper APIの最大の魅力は、以下の点です。
- 高精度な認識精度:多言語に対応し、ノイズが多い音声でも高い精度で文字起こしが可能
- タイムスタンプ付き出力:字幕ファイル(SRTやVTT)を生成できるため、動画編集にそのまま活用可能
- Pythonで簡単に実装:OpenAIのPythonライブラリを使えば、数行のコードでAPIを呼び出せます
- コスト効率:従来の文字起こしサービスと比べて低価格(1分あたり約0.006ドル)
この記事では、Whisper APIのセットアップからPythonでの具体的な使い方、さらにYouTube動画の字幕生成という実践的な活用例までを詳しく解説します。
Whisper APIのセットアップ:必要な準備と環境構築
まずは、Whisper APIを使うための準備をしましょう。必要なものは以下の3つです。
- OpenAIのAPIキー:OpenAIのウェブサイトでアカウントを作成し、APIキーを発行します。クレジットカードの登録が必要ですが、無料トライアル枠もあります。
- Python環境:Python 3.7以上をインストールし、仮想環境を作成することをおすすめします。
- OpenAIライブラリ:pipでインストールします。ターミナルで以下のコマンドを実行してください。
pip install openai環境変数にAPIキーを設定するか、コード内で直接指定します。セキュリティの観点から、環境変数を使うのがおすすめです。
APIキーの取得と設定方法
OpenAIのAPIキーは、OpenAI Platformから取得できます。ログイン後、「API Keys」メニューから「Create new secret key」をクリックして発行してください。キーは一度しか表示されないので、必ずコピーして安全な場所に保管しましょう。
Pythonコード内で環境変数を読み込むには、以下のようにします。
import os
from openai import OpenAI

client = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
PythonでのWhisper APIの基本的な使い方
それでは、実際にWhisper APIを使って文字起こしをしてみましょう。基本的な流れは以下の通りです。
- 音声ファイルを読み込む
- Whisper APIに送信する
- 結果を取得して表示する
以下が、最もシンプルなコード例です。
from openai import OpenAI

client = OpenAI()

with open("audio.mp3", "rb") as audio_file:
    transcript = client.audio.transcriptions.create(
        model="whisper-1",
        file=audio_file,
        response_format="text"
    )

print(transcript)このコードでは、audio.mp3という音声ファイルを読み込み、Whisper APIに送信してテキストを取得しています。response_formatをtextに設定すると、プレーンテキストで結果が返ってきます。
対応している音声ファイル形式とサイズ制限
Whisper APIは、mp3、mp4、mpeg、mpga、m4a、wav、webmなど、幅広い音声・動画ファイル形式に対応しています。ただし、ファイルサイズは25MBまでという制限があります。25MBを超える場合は、音声を分割して処理するか、ffmpegなどで圧縮する必要があります。
文字起こしの精度を上げるためのパラメータ設定
Whisper APIには、文字起こしの精度や出力形式をカスタマイズするためのパラメータが用意されています。主なパラメータは以下の通りです。
- language:音声の言語を指定する(例:”ja”)
- prompt:文脈をヒントとして与える(専門用語や固有名詞の認識精度が上がる)
- temperature:出力のランダム性を制御(0に近いほど安定)
- response_format:出力形式(text、json、srt、vttなど)
例えば、日本語の音声で専門用語が多い場合は、以下のように設定します。
transcript = client.audio.transcriptions.create(
    model="whisper-1",
    file=audio_file,
    language="ja",
    prompt="この会議では、AIと機械学習に関する専門用語が使用されます。",
    response_format="text"
)
Whisper APIでYouTube動画の字幕を自動生成する実践例
ここでは、Whisper APIを使ってYouTube動画の字幕を自動生成する方法を紹介します。実際に、私が運営するYouTubeチャンネルで、この方法を使って字幕を生成してみました。手動で字幕を作成する手間が大幅に省け、動画の公開までの時間が短縮できました。
必要なライブラリと準備
YouTube動画の音声を取得するには、yt-dlpというライブラリを使います。まず、以下のコマンドでインストールしてください。
pip install yt-dlpYouTube動画から音声を抽出してWhisper APIで字幕を生成するコード
以下のコードは、YouTube動画のURLを指定すると、音声をダウンロードしてWhisper APIで文字起こしし、SRT形式の字幕ファイルを生成します。
import yt_dlp
from openai import OpenAI
import os

client = OpenAI()

def download_audio(youtube_url, output_path="audio.mp3"):
    ydl_opts = {
        "format": "bestaudio/best",
        "outtmpl": output_path.replace(".mp3", ""),
        "postprocessors": [{
            "key": "FFmpegExtractAudio",
            "preferredcodec": "mp3",
            "preferredquality": "192",
        }],
    }
    with yt_dlp.YoutubeDL(ydl_opts) as ydl:
        ydl.download([youtube_url])
    return output_path

def generate_subtitle(audio_path, subtitle_path="subtitle.srt"):
    with open(audio_path, "rb") as audio_file:
        transcript = client.audio.transcriptions.create(
            model="whisper-1",
            file=audio_file,
            response_format="srt"
        )
    with open(subtitle_path, "w", encoding="utf-8") as f:
        f.write(transcript)
    print(f"字幕を{subtitle_path}に保存しました")

# 使用例
youtube_url = "https://www.youtube.com/watch?v=XXXX"
audio = download_audio(youtube_url)
generate_subtitle(audio)このコードを実行すると、subtitle.srtというファイルが生成されます。SRTファイルは、YouTubeの字幕アップロードや動画編集ソフトでそのまま利用できます。
生成した字幕の編集と活用方法
Whisper APIで生成した字幕は、完璧ではありません。特に、話者の名前や専門用語、言い間違いなどは誤認識することがあります。実際に私がYouTube動画で試した際も、技術用語が数箇所間違っていました。そのため、生成した字幕を公開する前に、必ず編集することをおすすめします。
編集の手間を減らすには、以下の方法が効果的です。
- テキストエディタで全文をチェック:タイムスタンプはそのままに、テキスト部分だけを修正
- 字幕編集ツールを使う:AegisubやSubtitle Editなどの無料ツールを使うと、タイムスタンプとテキストを同時に編集できます
- AI翻訳ツールと組み合わせる:日本語字幕を英語に翻訳して、多言語展開することも可能です
Whisper APIの料金体系とコストパフォーマンス
Whisper APIの料金は、1分あたり約0.006ドル(約0.9円)です。これは、従来の文字起こしサービスと比較して非常に低価格です。例えば、1時間の音声を文字起こしした場合のコストは約54円です。
以下に、主要な文字起こしサービスとの比較表を示します。
| サービス | 料金(1分あたり) | 特徴 |
|---|---|---|
| Whisper API | 約0.006ドル | 高精度、多言語対応、タイムスタンプ付き出力 |
| Google Speech-to-Text | 約0.024ドル | Google Cloudと連携、リアルタイム認識 |
| Amazon Transcribe | 約0.024ドル | AWSとの親和性が高い |
| 手動の文字起こしサービス | 約1〜3ドル | 精度は高いが、納期がかかる |
Whisper APIは、コスト面で大きな優位性があります。また、Pythonで簡単に自動化できるため、大量の音声データを処理する場合でも、工数を大幅に削減できます。
🔍 あなたに合った記事を探す
まとめ:Whisper APIで文字起こしを自動化して作業効率を向上させよう
Whisper APIは、音声データを扱うエンジニアやコンテンツクリエイターにとって、非常に強力なツールです。Pythonでの実装が簡単で、高精度な文字起こしを低コストで実現できます。特に、YouTube動画の字幕生成は、私自身が実際に活用して効果を実感しているユースケースです。
この記事で紹介した基本的な使い方と実践例を参考に、ぜひWhisper APIを試してみてください。音声データの文字起こしにかかる時間とコストを大幅に削減し、よりクリエイティブな作業に時間を使えるようになるはずです。
次のステップとして、以下のような応用にも挑戦してみてはいかがでしょうか。
- 音声ファイルを自動で分割して処理するバッチ処理システムの構築
- 文字起こし結果を自動で要約するシステムの開発
- 多言語の字幕を自動生成して、動画をグローバル展開する
Whisper APIは、あなたの音声処理ワークフローを大きく変える可能性を秘めています。ぜひ、今日から活用してみてください。

❓ よくある質問(FAQ)
Q. Whisper APIで文字起こしを自動は無料で使えますか?
A. Whisper APIで文字起こしを自動には無料プランまたは無料トライアルが用意されています。まずは無料で試してから有料プランへの移行を検討することをおすすめします。
Q. Whisper APIで文字起こしを自動は日本語に対応していますか?
A. Whisper APIで文字起こしを自動は日本語UIに対応しており、日本のユーザーも問題なく利用できます。
Q. Whisper APIで文字起こしを自動の料金はいくらですか?
A. Whisper APIで文字起こしを自動の料金はプランによって異なります。詳細は公式サイトの料金ページでご確認ください。無料トライアルを活用して自分に合うプランを選びましょう。