Pineconeとは?RAGに必要なベクターデータベースの基礎知識
📋 この記事でわかること
- ✅ 基本的な使い方と設定方法
- ✅ 実際の業務での活用例
- ✅ よくあるエラーと解決方法
- ✅ 効率的に使うためのコツ
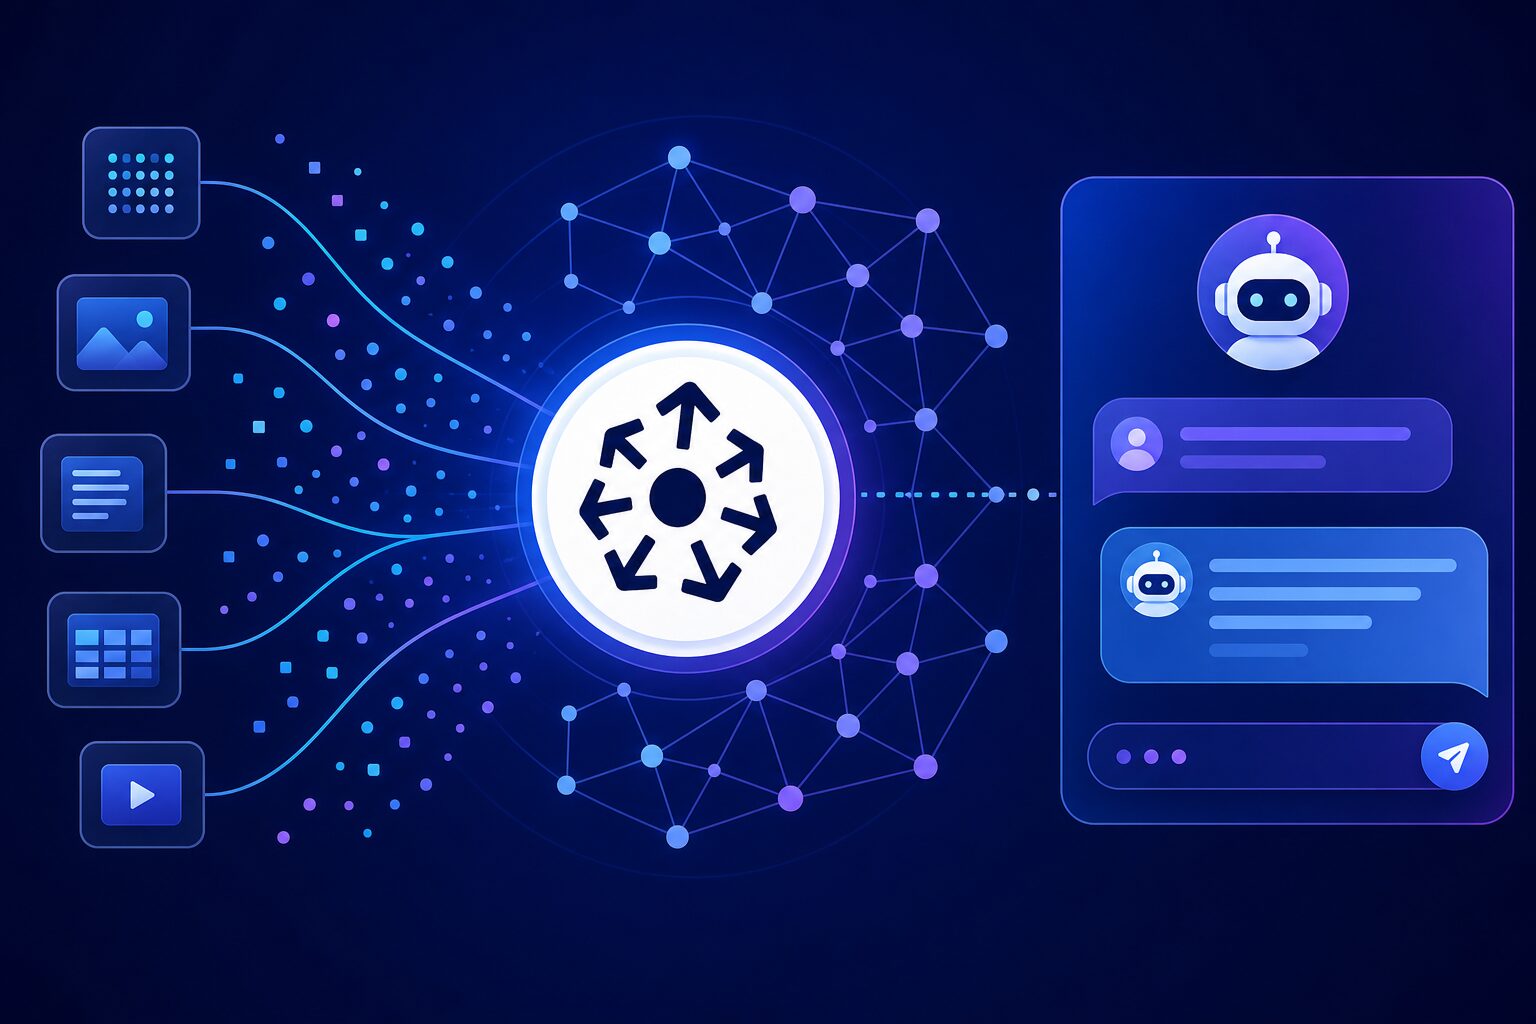
近年、大規模言語モデル(LLM)を活用したRAG(Retrieval-Augmented Generation)システムが注目を集めています。RAGは、外部のドキュメントやデータベースから関連情報を検索し、その結果をプロンプトに組み込んで回答を生成する手法です。このRAGの中核となるのが、ベクターデータベースです。
ベクターデータベースは、テキストや画像などのデータを高次元のベクトル(数値配列)に変換し、類似度検索を高速に実行するためのデータベースです。その中でもPineconeは、フルマネージド型のベクターデータベースサービスとして、多くのエンジニアに利用されています。
Pineconeの主な特徴
- フルマネージド:インフラ管理が不要で、APIを呼ぶだけで利用可能
- 高速な類似検索:数十億件のベクトルをミリ秒単位で検索
- スケーラビリティ:需要に応じて自動的にスケール
- マルチテナンシー:名前空間でデータを分離し、複数ユーザーに対応
Pineconeを利用すれば、自前でベクターインデックスを構築・運用する手間を省き、RAGシステムの開発に集中できます。特に、AWSやGCPなどのクラウド上で動作するため、既存のインフラとの統合も容易です。
Pineconeの始め方:アカウント作成からAPIキー取得まで
Pineconeの利用を開始するには、まず公式サイトでアカウントを作成します。無料プラン(Serverless Starter)が用意されており、1つのインデックスにつき最大10万ベクトルまで無料で利用できます。以下に、具体的な手順を示します。
ステップ1:サインアップ
- Pineconeの公式サイト(pinecone.io)にアクセス
- 「Get Started」ボタンからメールアドレスまたはGoogleアカウントで登録
- メール内の確認リンクをクリックして認証
ステップ2:APIキーの取得
ダッシュボードにログインすると、左側のメニューに「API Keys」があります。ここでAPIキーを作成します。このキーは、後ほどコードからPineconeにアクセスする際に必要になります。
ステップ3:インデックスの作成
次に、データを保存するためのインデックスを作成します。ダッシュボードの「Indexes」メニューから「Create Index」を選択し、以下の項目を設定します。
- Index Name:任意の名前(例:faq-index)
- Dimensions:使用する埋め込みモデルの次元数(例:OpenAIのtext-embedding-ada-002は1536次元)
- Metric:類似度計算方法(通常は「cosine」を選択)
- Cloud & Region:デプロイ先のクラウドとリージョン(例:AWS、us-east-1)
作成が完了すると、インデックスの接続情報(Host)が発行されます。これで準備完了です。
PythonでのPineconeの基本的な使い方:データ登録と検索
Pineconeの操作は、Pythonの公式クライアントライブラリを使用するのが最も簡単です。ここでは、基本的なデータの登録(アップサート)と検索(クエリ)の手順を解説します。
インストールと初期化
まず、Pineconeクライアントをインストールします。
pip install pinecone-client次に、Pythonコードで初期化を行います。
import pinecone

# APIキーと環境を設定
pinecone.init(api_key="YOUR_API_KEY", environment="us-east-1-aws")

# インデックスを取得
index = pinecone.Index("faq-index")
ベクトルの登録(アップサート)
テキストを埋め込みモデルでベクトル化し、インデックスに登録します。以下は、OpenAIのEmbedding APIを使った例です。
import openai

openai.api_key = "YOUR_OPENAI_API_KEY"

# テキストをベクトル化
def embed(text):
    response = openai.Embedding.create(
        input=text,
        model="text-embedding-ada-002"
    )
    return response["data"][0]["embedding"]

# 登録するデータ(FAQの質問と回答)
documents = [
    {"id": "faq1", "text": "返品ポリシーは?", "metadata": {"answer": "購入後30日以内であれば返品可能です。"}},
    {"id": "faq2", "text": "配送日数はどのくらい?", "metadata": {"answer": "通常3〜5営業日でお届けします。"}}
]

# ベクトル化して登録
vectors = []
for doc in documents:
    vec = embed(doc["text"])
    vectors.append({"id": doc["id"], "values": vec, "metadata": doc["metadata"]})

index.upsert(vectors=vectors)ここでポイントとなるのは、metadataに元のテキストや回答を保存しておくことです。検索時にはベクトルだけでなく、メタデータも取得できるため、RAGの回答生成にそのまま利用できます。
類似検索(クエリ)
ユーザーの質問をベクトル化し、インデックスから類似度の高いベクトルを取得します。
query = "返品できますか?"
query_vec = embed(query)

results = index.query(
    vector=query_vec,
    top_k=3,
    include_metadata=True
)

for match in results["matches"]:
    print(f"Score: {match['score']}, Answer: {match['metadata']['answer']}")
このように、PineconeのAPIはシンプルで、数行のコードでベクター検索を実装できます。検索結果のスコア(類似度)を確認することで、適切な回答を選択する精度を高めることが可能です。
実践:PineconeでFAQチャットボットを構築した体験談
私自身、Pineconeを使って社内向けのFAQチャットボットを開発する機会がありました。ここでは、その体験談を交えながら、実際の構築プロセスと注意点を紹介します。
構築の流れ
- 社内のFAQドキュメントを収集し、質問と回答のペアを整理
- 各質問をOpenAIのEmbedding APIでベクトル化し、Pineconeに登録
- ユーザーの質問を受け取り、ベクトル化してPineconeで類似検索
- 検索結果の回答をChatGPTのプロンプトに組み込み、自然な回答を生成
この流れの中で、Pineconeが非常にスムーズに動作しました。特に、フルマネージドであるため、インフラの設定に時間を取られることなく、開発に集中できたのが大きなメリットでした。
直面した課題と解決策
一方で、いくつかの課題もありました。まず、埋め込みモデルの選定です。当初は日本語に特化したモデルを使っていましたが、OpenAIのモデルでも十分な精度が得られたため、コストと精度のバランスを考慮して切り替えました。
また、メタデータの設計も重要です。FAQでは、カテゴリや対象製品などのメタデータを追加することで、フィルタリング検索が可能になり、精度が向上しました。
さらに、Pineconeの無料プランではインデックス数に制限があります。本番運用を考える場合は、有料プランへのアップグレードが必要になることを認識しておきましょう。
体験から得た教訓
Pineconeを利用することで、RAGシステムの開発が大幅に効率化されました。特に、APIが直感的でドキュメントも充実しているため、初めてベクターデータベースを触るエンジニアでも短期間で使いこなせると感じました。
Pineconeの料金プランとコスト削減のポイント
Pineconeの料金は、使用するプランによって異なります。主なプランは以下の通りです。
| プラン | 料金 | 特徴 |
|---|---|---|
| Serverless Starter | 無料 | 1インデックス、最大10万ベクトル |
| Serverless | 従量課金(1時間あたり$0.10〜) | 自動スケーリング、無制限のインデックス |
| Enterprise | カスタム | 専用サポート、SLA保証 |
コストを抑えるためには、以下のポイントに注意しましょう。
- 埋め込みモデルの選択:高次元のモデルは精度が高い一方、コストが増加します。用途に応じて次元数を調整
- データの削除管理:不要になったベクトルは定期的に削除し、ストレージ容量を最適化
- Serverlessプランの活用:トラフィックが変動する場合は、Serverlessプランがコスト効率的
Pineconeの代替ツールと比較:自分に合ったベクターデータベース選び
Pinecone以外にも、ベクターデータベースには様々な選択肢があります。代表的なものを比較してみましょう。
| ツール | タイプ | 特徴 |
|---|---|---|
| Pinecone | フルマネージド | 高速、スケーラブル、APIがシンプル |
| Weaviate | オープンソース | 自己ホスト可能、モジュール式、GraphQL API |
| Qdrant | オープンソース | Rust製で高速、フィルタリング機能が強力 |
| Chroma | オープンソース | 軽量、Pythonに最適、埋め込みモデル内蔵 |
Pineconeは、運用コストを抑えたい場合や、すぐに本番環境で利用したい場合に最適です。一方、コストを徹底的に削減したい場合や、カスタマイズ性を重視する場合は、オープンソースのツールを検討する価値があります。
🔍 あなたに合った記事を探す
まとめ:PineconeでRAG開発を加速させよう
Pineconeは、RAGシステムを構築するエンジニアにとって、非常に強力なツールです。シンプルなAPI、高速な検索性能、フルマネージドの運用性により、開発期間を大幅に短縮できます。今回紹介した基本的な使い方をマスターすれば、あなたもすぐにRAGシステムを構築できるでしょう。
ぜひ、無料プランから始めて、Pineconeの可能性を体感してみてください。

❓ よくある質問(FAQ)
Q. Pinecone入門:ベクターデータベーは無料で使えますか?
A. Pinecone入門:ベクターデータベーには無料プランまたは無料トライアルが用意されています。まずは無料で試してから有料プランへの移行を検討することをおすすめします。
Q. Pinecone入門:ベクターデータベーは日本語に対応していますか?
A. Pinecone入門:ベクターデータベーは日本語UIに対応しており、日本のユーザーも問題なく利用できます。
Q. Pinecone入門:ベクターデータベーの料金はいくらですか?
A. Pinecone入門:ベクターデータベーの料金はプランによって異なります。詳細は公式サイトの料金ページでご確認ください。無料トライアルを活用して自分に合うプランを選びましょう。